
sktime ist 1.0. Mit dieser Versionsnummer geht ein Versprechen einher: Sie sagt dir, was ein Upgrade an deinem Code ändern darf. sktime folgt semantischer Versionierung: Ein Patch enthält ausschließlich rückwärtskompatible Fehlerkorrekturen, ein Minor-Release ergänzt Funktionen, und inkompatible API-Änderungen bleiben einem Minor- oder Major-Release vorbehalten.
Der vorgeschaltete Deprecation-Zyklus ist nicht neu. sktime kündigt Entfernungen und Umbenennungen seit Jahren einen vollständigen Minor-Zyklus im Voraus an. Du erfährst davon durch eine Warnung in deinen Tests, bevor der Build fehlschlägt. Mit 1.0 zeigt nun auch die Versionsnummer selbst, welche Änderungen zulässig sind. Auf dieser Grundlage kannst du die hier vorgestellten Schnittstellen in Produktionssystemen einsetzen.
Dieses Versprechen steht und fällt mit der Wartung dahinter. Ein Kernteam entwickelt sktime nach einem öffentlichen Governance-Modell und mit regelmäßigen Releases. Auf Anfrage übernimmt dasselbe Team auch Enterprise-Projekte: den Betrieb in Unternehmen, Support mit SLA, eingebettete Entwicklungsteams, Schulungen und Beratung.
Das ist zuletzt hinzugekommen:
Foundation Models, eine Schnittstelle
33 Foundation-Model-Familien mit denselben Methoden fit und predict, davon 22 neu in der 1.0-Serie. Globales Forecasting läuft jetzt über eine Pretraining-API, die Modelle auch an deine eigenen Paneldaten anpasst.
Agentengestütztes Forecasting
AutoResearchForecaster schlägt Pipelines vor, bewertet sie auf deinen Daten und verbessert sie selbstständig. Das Ergebnis ist ein gewöhnlicher sktime-Forecaster.
Deep Learning mit torch
Neun Klassifikatoren und neun Regressoren besitzen jetzt native torch-Implementierungen zusätzlich zu Keras und TensorFlow. Eine Abhängigkeit für alle Aufgaben.
Erweitertes Benchmarking
Ein wiederverwendbares Framework mit sieben fertigen Katalogen, darunter der M4-Wettbewerb und der Klassifikationsvergleich von 2017. Fehlertolerant und nach Abstürzen fortsetzbar.
Deshalb behandelt dieser Beitrag drei Releases: 1.0.0 führte die neue API ein, 1.0.2 baute sie aus und 1.1.0 schloss das Änderungsfenster. Alles Folgende ist in 1.1.0 enthalten. Kam eine Funktion erst nach 1.0.0 hinzu, nennen wir das entsprechende Release.
Foundation Models: eine Schnittstelle, >30 Familien, >100 Modelle
Ein vortrainiertes Foundation Model auf deinen eigenen Daten, in vier Zeilen:
from sktime.datasets import load_airline
from sktime.forecasting.chronos2 import Chronos2Forecaster

y = load_airline()

forecaster = Chronos2Forecaster("amazon/chronos-2")
forecaster.fit(y, fh=range(1, 13))
y_pred = forecaster.predict()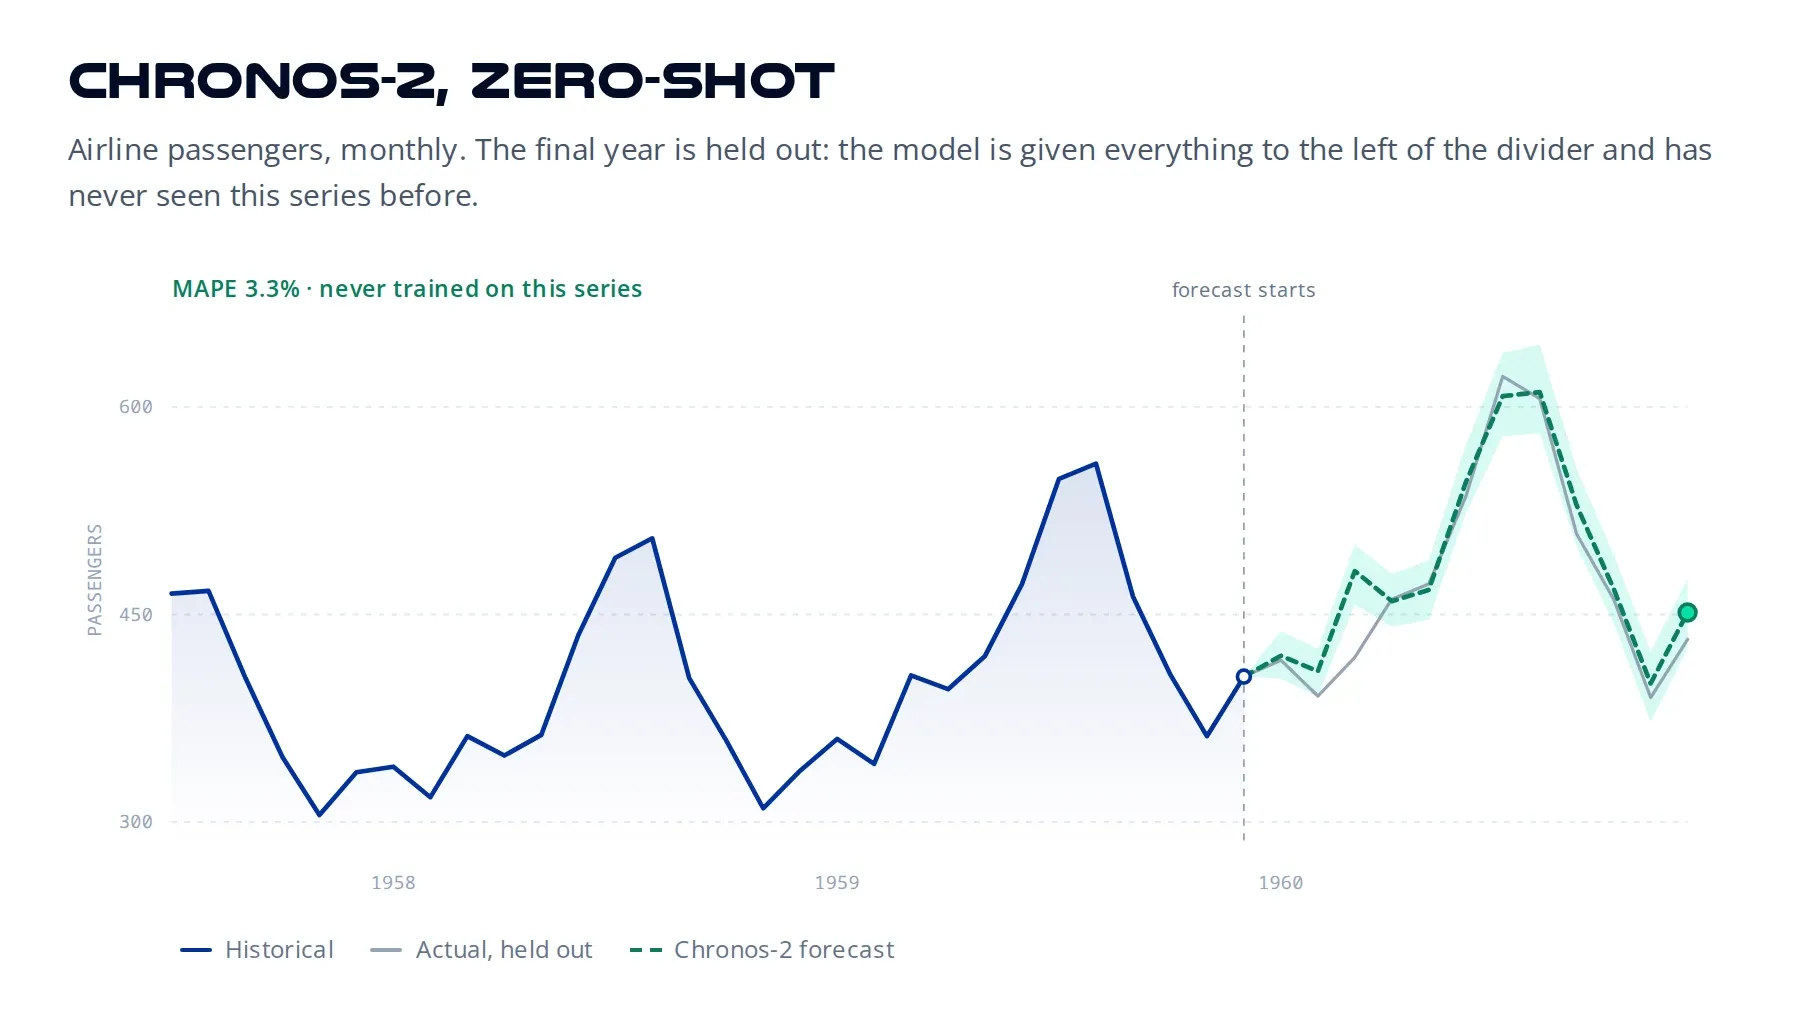
So wenig braucht es, um ein Foundation Model auf deine eigene Zeitreihe anzuwenden. Die sktime-Entwickler haben die Integration übernommen; für alle anderen Modelle gilt dieselbe Logik: Importiere eine andere Klasse, fertig. Ersetze Amazons Chronos-2 durch Googles TimesFM 2.5, ohne den übrigen Code zu ändern – obwohl die Modelle von unterschiedlichen Anbietern stammen, verschiedene Bibliotheken verwenden und andere Eingabeformate erwarten:
from sktime.datasets import load_airline
from sktime.forecasting.chronos2 import Chronos2Forecaster
from sktime.forecasting.timesfm2 import TimesFM2Forecaster

y = load_airline()
fh = range(1, 13)

for forecaster in [
    Chronos2Forecaster("amazon/chronos-2"),
    TimesFM2Forecaster("google/timesfm-2.5-200m-transformers"),
]:
    forecaster.fit(y, fh=fh)
    print(forecaster.predict().head(3))
Ohne sktime müsstest du diese Integration selbst schreiben. So erzeugst du drei Prognosewerte mit IBMs Tiny Time Mixer direkt über die Bibliothek des Anbieters:
import pandas as pd
from tsfm_public.toolkit.get_model import get_model
from tsfm_public.toolkit.time_series_forecasting_pipeline import (
    TimeSeriesForecastingPipeline,
)
from tsfm_public.toolkit.time_series_preprocessor import TimeSeriesPreprocessor

y = pd.Series([1, 2, 3, 4, 5])
df = pd.DataFrame(
    {
        "timestamp": pd.date_range("2024-01-01", periods=len(y), freq="D"),
        "value": y.to_numpy(),
    }
)

model = get_model(
    "ibm-research/ttm-r3",
    context_length=52,
    prediction_length=3,
    model_revision="52-16-dec-52-lite-r3",
)
preprocessor = TimeSeriesPreprocessor(
    timestamp_column="timestamp",
    target_columns=["value"],
    context_length=52,
    prediction_length=3,
    scaling=False,
    freq="D",
)
preprocessor.train(df)
pipe = TimeSeriesForecastingPipeline(
    model=model,
    feature_extractor=preprocessor,
    prediction_length=3,
    explode_forecasts=True,
    add_known_ground_truth=False,
)
print(pipe(df))
Dasselbe mit sktime:
import pandas as pd
from sktime.forecasting.ttm import TinyTimeMixerForecaster

y = pd.Series([1, 2, 3, 4, 5])
forecaster = TinyTimeMixerForecaster(
    model_path="ibm-research/ttm-r3", revision="52-16-dec-52-lite-r3"
)
forecaster.fit(y, fh=[1, 2, 3])
print(forecaster.predict())
# 5    6.072927
# 6    7.396875
# 7    8.460439
Dasselbe Modell, dieselben drei Zahlen. Kontextlänge und Vorverarbeitung sind weiterhin vorhanden, liegen aber hinter der Schnittstelle: als überschreibbare Standardwerte statt als wiederkehrender Integrationscode. Die Checkpoint-Revision musst du weiterhin selbst angeben, denn sie bestimmt das Modell. Ohne diese Angabe erhältst du den Standard-Checkpoint main mit anderen Gewichten und einem anderen Ergebnis.
Heute funktionieren 29 Forecaster auf diese Weise. Jeder erschließt eine Modellfamilie und nicht nur einen einzelnen Checkpoint; die Zahl erreichbarer Modelle ist daher deutlich größer. Die folgende Tabelle ist nach Nutzung des zugrunde liegenden Checkpoints sortiert. Die Spalte „Hinzugefügt“ nennt das Release; die 18 grün markierten Einträge sind seit 1.0 neu. Jeder Name führt zur API-Referenz mit Standard-Checkpoint und zusätzlichen Abhängigkeiten:
| Schätzer | Hinzugefügt | Modelljahr | Downloads / Monat |
|---|---|---|---|
Chronos2Forecaster | 1.0.0 | 2025 | 23.8M |
KronosForecaster | 1.0.0 | 2025 | 1.2M |
ChronosForecaster | früher | 2024 | 1.0M |
TiRexForecaster | früher | 2025 | 423K |
TinyTimeMixerForecaster | früher | 2024 | 329K |
Moirai2Forecaster | 1.0.2 | 2025 | 192K |
Toto2Forecaster | 1.0.2 | 2026 | 107K |
TimeMoEForecaster | früher | 2024 | 106K |
TotoForecaster | früher | 2025 | 83K |
MantisForecaster | 1.0.0 | 2025 | 80K |
FlowStateForecaster | 1.0.0 | 2025 | 72K |
TimesFM2Forecaster | 1.0.0 | 2026 | 63K |
SundialForecaster | 1.0.2 | 2025 | 41K |
MomentFMForecaster | früher | 2024 | 36K |
MOIRAIForecaster | früher | 2024 | 32K |
AuroraForecaster | 1.0.2 | 2026 | 6.3K |
TimerForecaster | 1.0.0 | 2024 | 4.6K |
PatchTSMixerForecaster | 1.0.0 | 2023 | 3.1K |
TimerS1Forecaster | 1.0.0 | 2026 | 1.1K |
CiscoTSMForecaster | 1.0.2 | 2026 | 903 |
FalconTSTForecaster | 1.0.0 | 2025 | 743 |
PatchTSTForecaster | früher | 2023 | 606 |
TimesFMForecaster | früher | 2024 | 600 |
MIRAForecaster | 1.0.2 | 2025 | 579 |
WindFMForecaster | 1.0.2 | 2025 | 567 |
LagLlamaForecaster | 1.0.0 | 2024 | n/a |
FalconXForecaster | 1.0.2 | 2026 | externe API |
Zwei weitere sind Adapter statt einzelner Modelle, weshalb Downloadzahlen wenig aussagen würden: HFTransformersForecaster unterstützt jeden kompatiblen Zeitreihen-Checkpoint von Hugging Face, und TimeLLMForecaster programmiert ein allgemeines Sprachmodell zum Forecaster um.
Forecasting ist nicht die einzige Aufgabe. 1.0 bringt auch MantisClassifier und TSPulseClassifier für Klassifikation sowie MomentFMAnomalyDetector und TSPulseAnomalyDetector für Anomalieerkennung. Dieselben Methoden fit und predict, eine andere Aufgabe. Das ergibt 33 Modellfamilien für drei Aufgaben, davon 22 neu in der 1.0-Serie.
Alle Foundation Models in der API-Referenz ansehen
Globales Forecasting und Pretraining auf eigenen Daten
Eines bleibt bei all diesen Modellen offen: Sie wurden auf fremden Daten vortrainiert, und Zero-Shot hat Grenzen. Deshalb führt 1.0 auch eine Pretraining-API ein, unter der Leitung von Simon Blanke (@SimonBlanke) mit Benedikt Heidrich (@benHeid), Felipe Angelim (@felipeangelimvieira) und Franz Király (@fkiraly).
Wenn Pretraining für dich neu ist
Die Idee hinter Foundation Models wird hier auf deine eigenen Daten übertragen. Ein Foundation Model kennt typische Zeitreihenmuster bereits, weil ein Anbieter es auf einem fremden Datenbestand trainiert hat. Pretraining ermöglicht dasselbe auf deinen Daten: etwa einigen Hundert Filialen oder Tausenden Artikeln. Jede Reihe allein ist möglicherweise zu kurz, gemeinsam liefern sie jedoch genug Information. Das Panel vermittelt gemeinsame Muster; fit spezialisiert das Modell anschließend auf die relevante Zielreihe. Hat diese selbst schon ausreichend Historie, genügt weiterhin ein einfaches fit.
Bei neuronalen Netzen beginnt Pretraining beispielsweise mit zufälligen Gewichten und trainiert das Netz auf einem Datenpanel. Beim anschließenden eigentlichen fit startet das Training dann mit diesen vortrainierten Gewichten.
Forecaster mit dem Tag capability:pretrain tun genau das: fit nach pretrain verfeinert das Modell, statt es zurückzusetzen. Die vortrainierten Gewichte bleiben erhalten. Das Training auf dem Panel erfolgt einmal; jede weitere Zeitreihe benötigt darauf aufbauend nur noch ein vergleichsweise günstiges fit und predict:
from sktime.datasets import load_hierarchical_sales_toydata
from sktime.forecasting.ltsf import LTSFLinearForecaster

y_panel = load_hierarchical_sales_toydata()

forecaster = LTSFLinearForecaster(seq_len=12, pred_len=6, num_epochs=5, batch_size=8)
forecaster.pretrain(y_panel)

y_target = y_panel.loc[y_panel.index.droplevel(-1).unique()[0]]
forecaster.fit(y_target, fh=range(1, 7))
y_pred = forecaster.predict()"new". pretrain() trainiert ihn auf einem Panel und setzt ihn auf "pretrained". fit() spezialisiert ihn auf eine Reihe und führt zu "fitted". Ohne Pretraining gelangst du mit fit() direkt dorthin. Der anschließende Aufruf von predict() bleibt gleich.Der Nutzen zeigt sich bei kurzen Zielreihen. Unten siehst du den monatlichen Absatz einer Produktlinie mit sechs zurückgehaltenen Monaten, zweimal prognostiziert vom selben LTSFLinearForecaster: einmal nach Pretraining auf 152 unabhängigen australischen Einzelhandelsreihen, einmal nur auf der Zielreihe trainiert. Jeweils fünf Epochen – das ist kein Benchmark-Ergebnis. Entscheidend ist der Unterschied. Das Pretraining-Notebook enthält den vollständigen Vergleich:
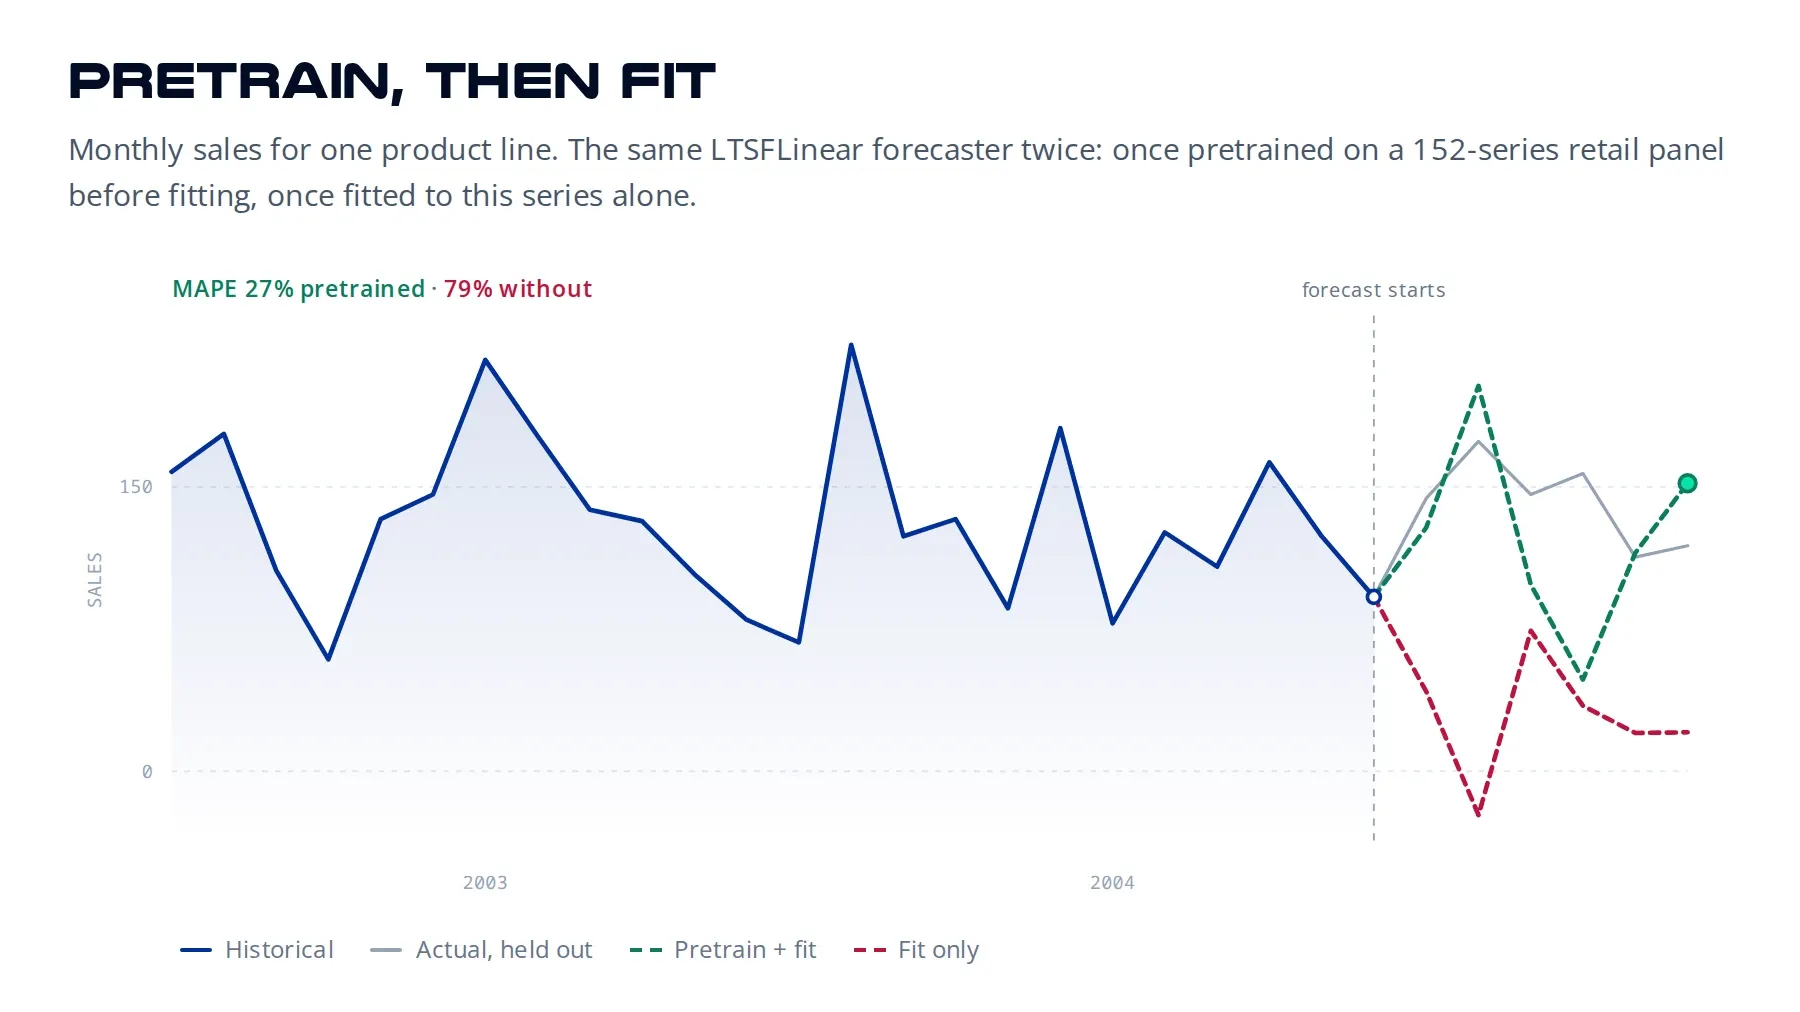
Das ersetzt die bisherige API für globales Forecasting. Vor 1.0 übernahmen zwei Methoden Teile der jeweils anderen Aufgabe: Das Panel ging an fit, die eigentliche Zielreihe als y an predict. Damit wurde der trainierte Forecaster vorübergehend auf unbekannte Daten umgelenkt. Das funktionierte, aber y hatte je nach Methode eine andere Bedeutung. Zudem war eine eigene Basisklasse nötig, die Pipelines und Tuner berücksichtigen mussten. 1.1.0 trennt die Rollen: pretrain erhält das Panel, fit die Zielreihe, und predict benötigt wieder keine Daten.
Zwei ähnlich klingende Fälle sind zu unterscheiden. Einen Forecaster auf einem Panel zu trainieren und alle darin enthaltenen Reihen vorherzusagen, funktioniert unverändert. Geändert hat sich der andere Fall: von einem Panel lernen und anschließend eine beim Training unbekannte Reihe prognostizieren. Diese neue Reihe ging früher an predict. Jetzt geht das Panel an pretrain und die neue Reihe an fit – also an die Methode, die Daten entgegennehmen soll.
In 1.1.0 tragen 14 Forecaster das Tag capability:pretrain, darunter die lineare LTSF-Familie, SCINetForecaster, TimesFM2Forecaster und seit 1.0.2 auch SundialForecaster und TinyTimeMixerForecaster. So listest du alle auf:
from sktime.registry import all_estimators

all_estimators(filter_tags={"capability:pretrain": True})
Deep Learning mit torch
Deep Learning in sktime bedeutete bisher Keras und TensorFlow. Seit 1.0 kannst du stattdessen durchgängig torch verwenden – dieselbe Abhängigkeit, die die Foundation Models oben bereits benötigen. Neun Klassifikatoren und neun Regressoren haben native Implementierungen mit dem Suffix Torch erhalten. Die TensorFlow-Versionen bleiben bestehen, sodass bisheriger Code weiterläuft. Aus sktime.classification.deep_learning: CNNClassifierTorch, InceptionTimeClassifierTorch, MACNNClassifierTorch, MCDCNNClassifierTorch, SimpleRNNClassifierTorch und TapNetClassifierTorch. ConvTran-, LSTM-FCN- und MLP-Varianten liegen in eigenen Untermodulen. sktime.regression.deep_learning exportiert die entsprechende Auswahl einschließlich MLPRegressorTorch.
from sktime.classification.deep_learning import CNNClassifierTorch
from sktime.datasets import load_unit_test

X_train, y_train = load_unit_test(split="train")
X_test, y_test = load_unit_test(split="test")

clf = CNNClassifierTorch(num_epochs=20, batch_size=8)
clf.fit(X_train, y_train)
y_pred = clf.predict(X_test)
Verlustfunktionen, Optimierer und Callbacks übergibst du als Strings oder Callables. Die meisten Modelle – allerdings nicht CNNClassifierTorch – akzeptieren außerdem ein Argument metrics, das Metriken aus torchmetrics direkt übernimmt.
Erweitertes Benchmarking
Foundation Models, eine Pretraining-API und ein Agent, der Pipelines erzeugt, werfen dieselbe Frage auf: Was funktioniert auf deinen Daten tatsächlich besser? Dafür wurde das Benchmarking überarbeitet. Es ist die größte einzelne Überarbeitung dieses Releases, von Jigyasu (@jgyasu), ergänzt um Post-hoc-Analysewerkzeuge von Yash Sangwan (@yash-sangwan).
Ein Benchmark besteht aus Schätzern, einer Aufgabe und einer Metrik. Hier tritt eine saisonale naive Prognose gegen ein kleines Foundation Model auf den Airline-Daten an, mit fünf wachsenden Zeitfenstern:
from sktime.benchmarking.forecasting import ForecastingBenchmark
from sktime.datasets import Airline
from sktime.forecasting.chronos import ChronosForecaster
from sktime.forecasting.naive import NaiveForecaster
from sktime.performance_metrics.forecasting import MeanAbsolutePercentageError
from sktime.split import ExpandingWindowSplitter

benchmark = ForecastingBenchmark()

benchmark.add(NaiveForecaster(strategy="last", sp=12))
benchmark.add(ChronosForecaster("amazon/chronos-bolt-tiny"))
benchmark.add(
    (
        Airline(),
        MeanAbsolutePercentageError(),
        ExpandingWindowSplitter(initial_window=24, step_length=24, fh=12),
    )
)

results = benchmark.run()
results ist ein DataFrame mit einer Zeile pro Schätzer. Jede Metrik liefert eine Spalte pro Fold sowie Mittelwert und Standardabweichung; Trainings- und Prognosezeiten folgen demselben Muster. Für einen kompakten Vergleich sortierst du nach dem Mittelwert:
metric = "MeanAbsolutePercentageError"
results.set_index("model_id")[f"{metric}_mean"].sort_values()
# model_id
# NaiveForecaster      0.135761
# ChronosForecaster    0.157366
# Name: MeanAbsolutePercentageError_mean, dtype: float64| Schätzer | MAPE (Mittelwert ± Standardabweichung) | Trainingszeit (s) |
|---|---|---|
NaiveForecaster | 0.1358 ± 0.0323 | 0.004 |
ChronosForecaster | 0.1574 ± 0.0929 | 0.482 |
Wenn dich die Niederlage eines Foundation Models überrascht
Die saisonale naive Prognose gewinnt hier, weil chronos-bolt-tiny der kleinste Checkpoint der Familie ist und ohne Anpassung auf einer einzigen kurzen Monatsreihe läuft. Unter diesen Bedingungen kann eine starke saisonale Baseline ein Foundation Model schlagen. Ein größerer Checkpoint, mehr Folds oder Pretraining auf verwandten Reihen könnten die Rangfolge ändern. Genau deshalb führst du einen Benchmark aus, statt dich auf eine Behauptung in einem Blogbeitrag zu verlassen.
Ein solcher Zero-Shot-Forecaster verwendet intern auch Sampling. Setze daher ChronosForecaster(..., seed=...), wenn du bei einem zweiten Lauf dieselben Zahlen erhalten möchtest.
Diese add-Aufrufe sind die erste Änderung. Seit 1.0.0 erkennt add selbst, was du übergibst: einen Schätzer, eine Liste oder ein Dictionary von Schätzern, ein Dataset-Objekt, eine Metrik, einen Cross-Validation-Splitter oder ein Tripel (dataset, metric, splitter) in beliebiger Reihenfolge. Dazu kommt ein neuer Objekttyp, der Katalog: eine deklarative, einsehbare Sammlung von Schätzern, Datensätzen, Metriken und Splittern, die du als Ganzes an einen Benchmark übergibst. Sieben sind in 1.0 enthalten: die sechs Kataloge des M4-Wettbewerbs sowie BakeOffCatalogue mit 85 Datensätzen und 13 Klassifikatoren aus dem Zeitreihen-Klassifikationsvergleich von 2017.
Ein Blick in einen Katalog lohnt sich vor dem Start. Der jährliche M4-Katalog enthält die neun statistischen Baselines des Wettbewerbs mit genau den damals verwendeten Parametern:
from sktime.catalogues import M4CompetitionCatalogueYearly

M4CompetitionCatalogueYearly().get("forecaster")
# [{'Naive_1': "NaiveForecaster(strategy='last')"},
#  {'SES': 'ExponentialSmoothing(trend=None, seasonal=None)'},
#  {'Holt': "ExponentialSmoothing(trend='add', seasonal=None)"},
#  {'Damped': "ExponentialSmoothing(trend='add', damped_trend=True)"},
#  {'Theta': 'ThetaForecaster()'},
#  {'AutoARIMA': 'AutoARIMA()'},
#  {'AutoETS': 'AutoETS()'},
#  {'Comb': 'EnsembleForecaster(...)'},  # abbreviated: mean of SES, Holt, Damped
#  {'Naive_S': "NaiveForecaster(strategy='last', sp=1)"}]
Der Datensatz und die drei Wettbewerbsmetriken liegen im selben Objekt unter get("dataset") und get("metric"). Du siehst also vor dem Rechnen, womit du verglichen wirst und woran deine Ergebnisse gemessen werden.
Zur Reproduktion dieser Baselines brauchst du dann einen Katalog, einen Splitter und einen Pfad:
from sktime.benchmarking.forecasting import ForecastingBenchmark
from sktime.catalogues import M4CompetitionCatalogueYearly
from sktime.split import ExpandingWindowSplitter

catalogue = M4CompetitionCatalogueYearly()
benchmark = ForecastingBenchmark(backend="loky")

benchmark.add(catalogue)
benchmark.add(ExpandingWindowSplitter(initial_window=12, step_length=2, fh=6))

results = benchmark.run("./m4_yearly_results.csv")
Mit einem weiteren add nimmst du deinen eigenen Schätzer in denselben Benchmark auf und vergleichst ihn unter gleichen Bedingungen mit veröffentlichten Baselines. Das M4-Wettbewerbs-Notebook führt durch den vollständigen Lauf.
Die zweite Änderung, ebenfalls aus 1.0.2, wird bei mehrstündigen Läufen wichtig. Benchmarks sind fehlertolerant: Schlägt ein Aufgaben-Schätzer-Paar fehl, wird das protokolliert und der Lauf geht weiter. Am Ende erscheinen eine zusammenfassende Warnung und Details in benchmark.failed_experiments. Auch Abstürze sind abgesichert. Jedes abgeschlossene Paar wird sofort in ein .parts/-Verzeichnis neben der Ausgabedatei geschrieben. Ein erneuter run mit demselben Pfad setzt nach Absturz, Timeout oder Stromausfall dort fort. Mit force_rerun="all" oder einer Liste von Schätzer-IDs erzwingst du eine Wiederholung. Für Cluster-Läufe bietet sktime-benchmark ein ausgearbeitetes Slurm-Beispiel.
Die Analysewerkzeuge aus 1.0.2 lesen direkt den Ergebnis-DataFrame oder dessen Dateipfad. Sie vergleichen Schätzer über mehrere Datensätze hinweg und benötigen daher einen Lauf mit mehreren Aufgaben. Hier enthält results vier klassische Forecaster auf Airline, Lynx und ShampooSales:
from sktime.benchmarking.analysis import AverageRank, FriedmanTest

metric = "MeanAbsolutePercentageError"

AverageRank(metric=metric).evaluate(results)
#   model_id      rank
# 0    Trend  1.000000
# 1    Theta  2.666667
# 2    Naive  3.000000
# 3     Mean  3.333333

FriedmanTest(metric=metric).evaluate(results)
#    statistic   p_value
# 0        5.8  0.121757
TrendForecaster belegt Platz eins. Der Friedman-Test erkennt jedoch keinen signifikanten Unterschied – bei drei Datensätzen das angemessene Ergebnis. Ein nachgelagerter NemenyiTest wäre erst sinnvoll, wenn der globale Test die Nullhypothese verwirft.
AverageRank, FriedmanTest, NemenyiTest, WilcoxonSignedRankTest, SignTest, RankSumTest, TwoSampleTTest und CriticalDifferenceDiagram stehen in sktime.benchmarking.analysis bereit. Beachte: Die Analysatoren benötigen eine vollständige Ergebnismatrix. Vervollständige oder filtere Läufe mit fehlgeschlagenen Experimenten, bevor du Ranglisten berechnest.
Agentengestütztes Forecasting
Aus den Foundation Models oben das passende Modell und anschließend die richtige Pipeline auszuwählen, kostet Arbeit. Auch diesen Teil kann 1.0 für dich übernehmen.
AutoResearchForecaster, beigetragen von Benedikt Heidrich (@benHeid), übergibt den Pipeline-Entwurf an ein Sprachmodell. Es schlägt Spezifikationen vor, baut sie über die sktime-Registry auf, bewertet jede mit einer echten Cross-Validation-Aufteilung auf deinen Daten und nutzt die Ergebnisse für verbesserte Vorschläge. Nach fit liegt die ausgewählte Pipeline als gewöhnlicher sktime-Forecaster in best_forecaster_:
from sktime.datasets import load_airline
from sktime.forecasting.agentic import AutoResearchForecaster
from sktime.split import SingleWindowSplitter

y = load_airline()

forecaster = AutoResearchForecaster(
    cv=SingleWindowSplitter(fh=[1, 2, 3]),
    model="openai/gpt-4o-mini",
    n_iterations=2,
    n_blueprints=3,
)
forecaster.fit(y, fh=[1, 2, 3])
y_pred = forecaster.predict(fh=[1, 2, 3])

forecaster.best_forecaster_
forecaster.blueprint_history_
So baut AutoResearchForecaster eine Pipeline
1Trainingsdaten
- Die Zielreihe
yund optional exogene VariablenX - Eine Beschreibung des Datensatzes: einfache Statistiken, die Interpretation eines Diagramms durch ein Bildmodell oder das Diagramm selbst, je nach
description_method
2Prompt-Kontext
- System-Prompt: das Blueprint-Format, die Spezifikationsregeln und die Klassennamen aller verfügbaren sktime-Forecaster und -Transformer
- Nutzernachricht: die Datensatzbeschreibung und das Diagramm, falls das Modell Bilder verarbeiten kann
Wiederholung: n_iterations-mal
EntwerfenLLM-Aufruf
Das LLM schlägt n_blueprints Pipeline-Entwürfe vor, jeweils mit Namen, Begründung und einer Spezifikation für craft().
Detrender() * AutoARIMA()
Bewertensktime
craft() baut aus jeder Spezifikation einen Forecaster, evaluate() bewertet ihn per Cross-Validation. Ein Fehler stoppt den Lauf nicht: Das LLM erhält n_fix_attempts Versuche, eine fehlerhafte Spezifikation zu reparieren.
score = MAPE = 0.0421
VerbessernLLM-Aufruf
Das LLM sieht alle bisherigen Entwürfe nach Ergebnis sortiert. Es soll den besten verbessern, Fehler beheben und neue Kombinationen ausprobieren.
best_score_ = 0.0421
alle Entwürfe nach Ergebnis ordnen
Die sortierten bisherigen Ergebnisse fließen in die nächste Entwurfsrunde ein
3Auswählen und neu trainieren
best_blueprint_: die beste Spezifikation über alle Iterationen- Mit
craft()neu aufgebaut und auf dem gesamten Trainingsdatensatz trainiert: Das ergibtbest_forecaster_
4Prognose
predict(fh)liefert die Prognose vonbest_forecaster_summary()liefert alle getesteten Entwürfe, nach Ergebnis sortiert
fit schlägt ein LLM sktime-Pipelines vor. sktime bewertet sie auf echten Daten; die Ergebnisse fließen zurück an das LLM und bestimmen die nächste Runde. Du erhältst die beste Pipeline über alle Runden. Entspricht sktime/forecasting/agentic/_autoresearch.py in 1.1.0.Modellaufrufe laufen über litellm; alle davon unterstützten Anbieter sind möglich. Setze den passenden API-Schlüssel in deiner Umgebung. Plane zwei Dinge ein: Die Suche verbraucht Tokens, und mit einem Sprachmodell müssen zwei Läufe nicht bei derselben Pipeline enden. Der Suchraum ist jedoch die sktime-Registry. Das Ergebnis bleibt ein gewöhnliches sktime-Objekt, das du untersuchen, serialisieren und anschließend ohne weitere Sprachmodellaufrufe ausführen kannst.
Ergänzend stellt [sktime-mcp](https://github.com/sktime/sktime-mcp) die Registry und Semantik von sktime jedem MCP-fähigen Assistenten zur Verfügung. So kann ein LLM Schätzer direkt entdecken und einordnen. Das von Shashank Shekhar Singh beigetragene Paket hat einen eigenen Release-Zyklus.
Weitere Änderungen
Die vier Themen oben wären unsere Auswahl für ein Poster. Ein Major-Release bewegt aber mehr. Hinzu kommen klassische Schätzer, Metriken und Schnittstellenkorrekturen, für die ein Versionswechsel der richtige Zeitpunkt ist.
Statistische und klassische Ergänzungen in 1.0.2
Die Arps-Forecaster ArpsExponential, ArpsHyperbolic und ArpsHarmonic in sktime.forecasting.arps_dca stammen von Santiago Cuervo (@scuervo91). Sie bringen die üblichen Modelle für den Rückgang der Erdölförderung in sktime, mit probabilistischen Prognosen über eine empirische Verteilung:
import numpy as np
import pandas as pd
from sktime.forecasting.arps_dca import ArpsHyperbolic

# three years of monthly production from a declining well
t = np.arange(36)
y = pd.Series(
    1000 / (1 + 0.8 * 0.12 * t) ** (1 / 0.8),
    index=pd.period_range("2023-01", periods=36, freq="M"),
)

forecaster = ArpsHyperbolic()
forecaster.fit(y, fh=range(1, 13))
y_pred = forecaster.predict()
y_pred_int = forecaster.predict_interval(coverage=0.9)
Ebenfalls neu: HyperTreeNetARForecaster als Schnittstelle zu hypertrees-forecasting; sieben Genauigkeitsmetriken nach Chen und Yang (2004) in sktime.performance_metrics.forecasting, beigetragen von Michael Ellis (@michaelellis003), darunter RMSEnormalizedByIQR, TheilU2 und drei KL-Divergenzvarianten; MiniRocketMultivariateCython, ein MiniRocket ohne numba und JIT-Aufwärmphase mit parallelem n_jobs; sowie EvoForestTSWM, ein Merkmalsextraktor mit geschlossener Berechnungsform.
Bereits 1.0.0 ergänzte Johansen-Kointegration und Impulsantwortfunktionen für VAR-Modelle in sktime.param_est, von @OldPatrick, sowie die Merkmalsextraktoren tsfeatures, tsfel und DegreeDayFeatures von Faakhir Zahid (@Faakhir30) und Zack Stinnett (@zstinnett3). Außerdem wurde skchange in sktime integriert: Seine Algorithmen zur Erkennung von Strukturbrüchen und Anomalien sind jetzt native Schätzer in sktime.detection.
Was sich geändert hat und was du tun solltest
Fünf dieser Korrekturen solltest du vor einem Upgrade kennen.
Ganzzahlige Prognosehorizonte sind eindeutig. fh=3 bedeutet jetzt [1, 2, 3], also die nächsten drei Perioden. Zuvor war nur die dritte Periode gemeint. Prüfe daher alle Stellen, an denen du eine einzelne Ganzzahl übergibst:
from sktime.datasets import load_airline
from sktime.forecasting.naive import NaiveForecaster

y = load_airline()  # monthly, ends 1960-12
NaiveForecaster().fit(y, fh=3).predict()
# 1961-01    432.0
# 1961-02    432.0
# 1961-03    432.0
#
# before 1.0, the same call returned one row: 1961-03
Capability-Tags sind einheitlich. Aus ignores-exogeneous-X wurde capability:exogenous, aus univariate-only wurde capability:multivariate. Beide kehren den booleschen Wert um, weil die neuen Namen beschreiben, was ein Schätzer kann. Auch scitype:y wird durch capability:multivariate ersetzt. Das betrifft Tag-Abfragen und eigene Schätzer.
Die Modulstruktur ist flacher. sktime.transformations.series.* und sktime.transformations.panel.* entfallen; importiere direkt aus sktime.transformations.*. Dasselbe gilt für sktime.detection. Der frühere Typ series-annotator heißt jetzt detector. Die alten Importpfade funktionieren während der 1.x-Serie weiter.
Installationen sind schlanker. all_extras installiert nicht länger sämtliche schätzerspezifischen Abhängigkeiten. Diese stehen pro Schätzer im Tag python_dependencies und werden nach Bedarf installiert. Erst das macht eine so große Auswahl an Foundation Models praktikabel. Ebenfalls entfernt wurden die eingebundene Kopie sktime.libs.pykalman – installiere pykalman selbst – und der veraltete ColumnTransformer.
Für Erweiterungen gilt zusätzlich: __init__ dient nur noch dazu, Argumente an self zuzuweisen. Dynamische Tags gehören in __dynamic_tags__, sonstige Initialisierung in __post_init__.
Auch capability:global_forecasting ist veraltet. Nach dem Wegfall der alten API für globales Forecasting erzeugt das Lesen dieses Tags bis zur Entfernung in 1.2.0 eine Warnung. Tag-Abfragen werden nicht umgeleitet, weil Schätzer aus älteren Versionen beide Tags tragen. Filtere daher nach capability:pretrain.
Diese Deprecations und die genannten Tag-Aliase bilden das gesamte Release 1.1.0, das zwei Tage nach 1.0.2 erschien. Deshalb lohnt sich der Zwischenschritt über 1.0.2: Läuft es ohne Deprecation-Warnungen, verändert 1.1.0 für dich nichts.
Alle Details stehen im Changelog.
Loslegen
pip install --upgrade sktime- Neu bei sktime? Beginne mit den Tutorials und Beispiel-Notebooks.
- Du schreibst eigene Schätzer? Nutze die Erweiterungsvorlagen.
- Du suchst etwas Bestimmtes? Die API-Referenz dokumentiert alle Schätzer.
Offen entwickelt
sktime steht unter der BSD-Lizenz, wird offen verwaltet und arbeitet mit dem PyData-Ökosystem zusammen. In 1.1.0 umfasst es 616 Schätzer, darunter 153 Forecaster, 150 Transformer, 77 Klassifikatoren, 46 Metriken, 30 Regressoren und 28 Detektoren. Es wird etwa eine Million Mal pro Monat von PyPI heruntergeladen. 636 Menschen haben Commits beigetragen.
Nicht nur Code zählt. sktime folgt der all-contributors-Spezifikation und würdigt auch Dokumentation, Tutorials, Reviews, Issue-Triage, Veranstaltungsorganisation und Design. Es gibt ein Mentoring-Programm, wöchentliche Community-Treffen und immer geeignete Einstiegs-Issues.
Vielen Dank
113 Menschen haben zu 1.0.0, 1.0.2 und 1.1.0 beigetragen, einige zum ersten Mal:
@12jaspreetsingh, @Abelarm, @abhimanyudalal1, @adan-shahid, @adrynalean, @algojogacor, @alphaleporus, @AMBRA7592, @aminehd, @Aniketsy, @Ankit-1204, @archittmittal, @Ask-812, @AYUSH27112021, @AyushI7G, @benHeid, @Chetansahney, @CloseChoice, @crocmons, @DCchoudhury15, @Deep-Axe, @direkkakkar319-ops, @EmanAbdelhaleem, @ericjb, @Faakhir30, @fkiraly, @FlyingDragon112, @G26karthik, @Gautam-Bharadwaj, @geetu040, @Giggitycountless, @gnanadeep256, @goyaladitya05, @gun29may, @gupta-tilak, @haosenwang1018, @harish885, @Ironankit525, @JATAYU000, @jdhruv555, @jgyasu, @joshdunnlime, @julian-fong, @junaidaslam2006, @kayuksel, @kerimkarakan, @Kevin23-design, @kiwoongyoon, @kpal002, @Krishna21435, @kumarshobhit, @loulanyue, @marrov, @michaelellis003, @Mohit25f101, @NAME-ASHWANIYADAV, @narges-aibi, @neha222222, @neharoy3, @NestroyMusoke, @nikol-damyanova, @Nischal1425, @nvphungdev, @OfficialAbhinavSingh, @OldPatrick, @onkar717, @paramsureliya, @PewterZz, @phoeenniixx, @piyushbiraje, @PragnyaKhandelwal, @pranavvp16, @purvanshjoshi, @pyarchana, @R2-STAR, @rakshaak29, @RecreationalMath, @Rishav23av, @Rusheel86, @sabasiddique1, @SajeelHussain, @Saloni-0465, @SAY-5, @scuervo91, @shaun0927, @siddharth7113, @SimonBlanke, @Si-ra-kri, @snoopuppy582, @Solaris-star, @Sonika-19, @Spandan-Mishra, @SpitFire19, @srupat, @sssilvar, @stephanielees, @TenFinges, @thecaptain789, @thisisrick25, @ubermensch19, @varun-kht, @Vbhatt03, @vedantag17, @vedhakoushik, @VenkateshHJoshi, @vortex-wq, @wali-reheman, @XAheli, @xenonnn4w, @yash-sangwan, @zanieb, @ziad-ashraf7, @zstinnett3
Wie es weitergeht
Die Arbeit geht in denselben Richtungen weiter: mehr Foundation Models, umfassenderes globales Forecasting und weitere agentengestützte Werkzeuge. Die Roadmap ist öffentlich. Am schnellsten gestaltest du sie mit, indem du ein Issue oder einen Pull Request eröffnest.